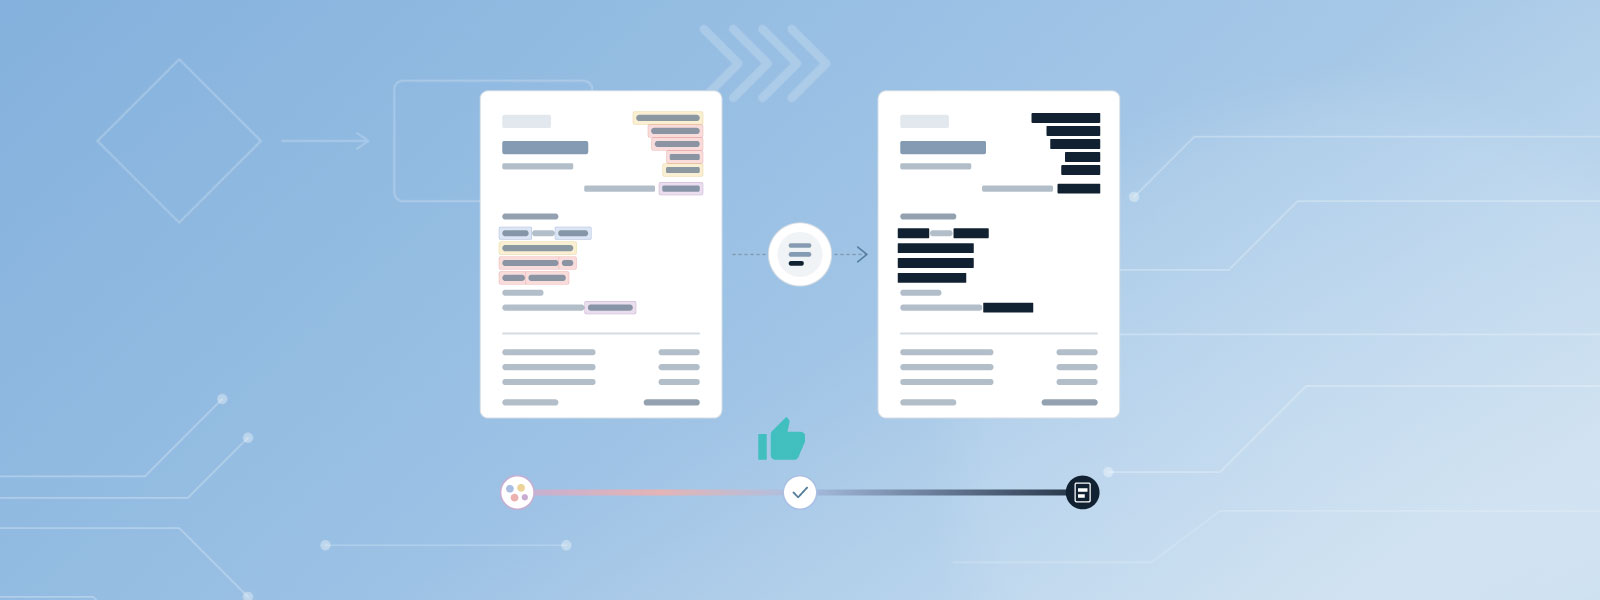
Las sentencias judiciales contienen una gran cantidad de datos personales y otra información sensible que debe identificarse antes de su publicación, evaluarse en su contexto y protegerse de forma específica. Al mismo tiempo, la fundamentación jurídica debe seguir siendo comprensible: ¿qué hechos fueron decisivos y cómo llegó el tribunal a su conclusión?
Por lo tanto, anonimizar sentencias judiciales require algo más que ocultar los nombres con barras negras. La inteligencia artificial puede ayudar a identificar datos potencialmente sensibles. Sin embargo, sigue siendo fundamental contar con un proceso en el que se revisen los resultados, se añadan los elementos que hayan podido pasar desapercibidos y se compruebe finalmente el archivo destinado a su publicación.
Por qué las barras negras por sí solas no son suficientes
Ocultar visualmente información sensible no constituye una anonimización segura. Si el texto original permanece en el PDF, en determinadas circunstancias puede seguir siendo posible copiarlo o extraerlo. Una anonimización técnicamente correcta, en cambio, elimina de forma permanente del documento el contenido de texto e imagen seleccionado, de modo que posteriormente tampoco pueda accederse a él técnicamente.
El contexto es relevante
No es necesario eliminar de la misma manera toda la información potencialmente sensible en todos los documentos. Lo decisivo son las normas de protección vigentes, el contexto y la importancia que tiene la información para comprender la decisión.
El objetivo es eliminar la información que debe protegerse y, al mismo tiempo, preservar en la medida de lo posible el contenido de la sentencia.

Las reglas configurables ayudan a dar respuesta a diferentes requisitos. La organización establece, por ejemplo, qué grupos de datos —las denominadas «clases de entidad»— deben tenerse especialmente en cuenta en cada procedimiento. Entre ellos pueden figurar nombres, direcciones u otros datos identificativos. Los usuarios comprueban cada una de las entradas basándose en estas especificaciones y deciden qué ajustes son necesarios en cada contexto concreto.
Ejemplo: Por qué las cantidades de dinero requieren una decisión caso por caso
Las cantidades monetarias ponen de manifiesto por qué las normas generales rígidas no son suficientes. El precio de compra, el importe de los daños o la indemnización concedida pueden ser fundamentales para comprender una sentencia. Si se omite la información correspondiente, es posible que la resolución ya no se pueda entender en su totalidad.
Por otro lado, una cantidad también puede contribuir a identificar a una persona o un caso cuando se combina con otros datos. Un posible ejemplo sería un precio de compra que, junto con una ubicación concreta y una descripción poco habitual del inmueble, permita identificar un negocio conocido públicamente. En estos casos, lo relevante no es la cantidad por sí sola, sino la combinación de información. Para el tratamiento de los documentos, esto significa que las cantidades de dinero deberían anonimizarse de forma indiscriminada. Las reglas específicas para cada tipo de documento pueden facilitar la revisión; sin embargo, sigue siendo importante evaluar cada referencia en su contexto.
Reconocimiento de entidades basado en IA para grandes volúmenes de documentos
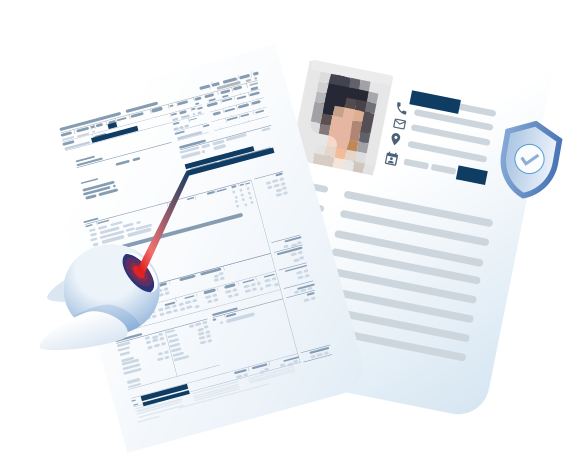
El tratamiento manual de documentos individuales puede resultar útil. En el caso de volúmenes más grandes, es recomendable recurrir a la ayuda que ofrece el reconocimiento automático. CIB PoP (Protect our Privacy) es una solución basada en inteligencia artificial para la detección y eliminación de datos personales en documentos. La solución está diseñada también para procesar grandes volúmenes de documentos.
La detección automática debería constituir el punto de partida para una comprobación más exhaustiva, y no su conclusión. Los reponsable revisan los puntos detectados, los evalúan en su contexto y realizan las modificaciones necesarias.
La revisión también debe incluir aquellos contenidos que no formen parte de las sugerencias automáticas. En la revisión técnica, por ejemplo, pueden ser relevantes las anotaciones manuscritas, las firmas o los elementos identificativos de la imagen. Los contenidos que realmente deben protegerse dependen del documento en cuestión y de las especificaciones correspondientes.
De este modo, un procedimiento basado en la inteligencia artificial combina la detección automatizada con el control por parte de expertos: la tecnología facilita el procesamiento, mientras que la evaluación del resultado sigue siendo responsabilidad de las personas responsables.
Cómo comprobar la calidad y la integridad del proceso de anonimización
Incluso un proceso de anonimización en gran medida automatizado requiere un control de calidad final. Para ello, resultan útiles las opciones de verificación adicionales, como una búsqueda basada en texto o la consideración específica de mayúsculas y minúsculas.
Para las organizaciones que cuentan con procesos definidos de revisión y aprobación, CIB flow permite agrupar los distintos pasos de trabajo en un flujo regulado. La plataforma permite, entre otras cosas, la edición de documentos, la gestión de tareas, la gestión de derechos y el registro de actividades. Asimismo, CIB PoP puede integrarse como módulo de IA en los procesos correspondientes.
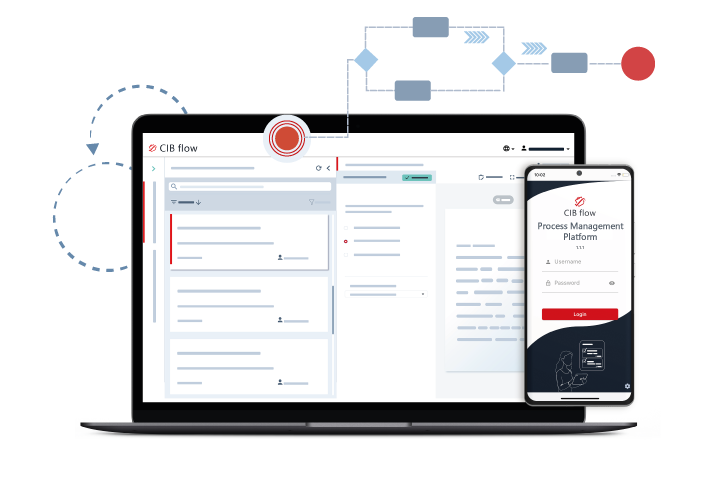
Un posible proceso abarca desde la detección automatizada, pasando por la revisión especializada y la comprobación técnica de los resultados, hasta la aprobación de la versión para su publicación. Las responsabilidades y los pasos de verificación necesarios se establecen de acuerdo con los requisitos de la organización.
La automatización de procesos no sustituye la decisión técnica, sino que facilita su ejecución y documentación de forma sistemática.
Conclusión: la publicación segura es el resultado de una combinación de factores
La anonimización de las sentencias judiciales no es ni un simple paso ni, por sí sola, una cuestión de la tecnología empleada. Lo fundamental es combinar cuatro elementos:
- reconocimiento automatizado
- revisión contextual
- eliminación definitiva
- aprobación documentada
Este procedimiento tiene por objeto proteger la información personal y, al mismo tiempo, preservar en la medida de lo posible el valor jurídico de la resolución. Para ello, se necesitan reglas claras y un control de la versión realmente publicada.
CIB PoP detecta los datos personales sensibles y los procesa de forma específica. En combinación con CIB flow, los pasos posteriores de verificación y autorización pueden representarse y controlarse como un proceso estructurado.
Preguntas frecuentes
Una barra negra solo puede ocultar el texto que hay debajo. Si este se conserva en el PDF, es posible que, en determinadas circunstancias, se pueda seguir copiando, buscando o extrayendo. En cambio, un ocultamiento técnicamente correcto elimina de forma permanente los contenidos seleccionados de la versión publicada.
Un control de calidad puede combinar diferentes pasos de verificación, como, por ejemplo, una búsqueda específica de texto y la comprobación de las entidades detectadas. Además, es importante que el control se realice de forma trazable y repetible.
La automatización de procesos puede ayudar a representar y documentar de forma estructurada los pasos de verificación, las responsabilidades y las autorizaciones.
El tratamiento de grandes volúmenes de expedientes de forma puramente manual requiere mucho tiempo. El reconocimiento automatizado de entidades permite identificar rápidamente los contenidos relevantes y, de este modo, agilizar el procesamiento.
La revisión humana sigue siendo importante, sobre todo en aquellos casos en los que es necesario tomar decisiones basadas en el contexto o en los que la información no puede detectarse de forma fiable mediante procesos automatizados.